Оптические нейронные сети обрабатывают информацию светом. Они могут обеспечить быстрые и энергоэффективные вычисления, но настоящий прибор редко точно совпадает с идеальным проектом. Модель, обученная в симуляции, может потерять точность из-за физического смещения, аберраций и отклика компонентов. 18 ноября исследователи Stanford и EPFL опубликовали статью об агенте, обучающем оптическую сеть напрямую по измерениям камеры. Важен структурированный испытательный цикл, а не общее доказательство того, что языковые модели понимают все физические процессы. Научная статья
Авторы представляют «optics as code». Агент предлагает программы и фазовые маски, стенд показывает их на пространственном модуляторе, возвращает снимки и позволяет сохранять гипотезы с наблюдениями. Лучший запуск классификатора с прежними заметками достиг 96,8% на тестовом наборе. Лучшая безградиентная база получила 52,5%, обучение обратным распространением через калиброванную модель — 96,3%. Это заслуживает внимания для данной установки. Все три результата происходят из одного лабораторного монтажа и определённых задач. Полный текст и методы
Прибор отличается от идеальной модели#
В эксперименте лазерный свет отражается между областями пространственного модулятора. Некоторые области кодируют вход, а две показывают обучаемые фазовые маски. Камера измеряет интенсивность выхода. При классификации рукописных нуля, единицы и двойки система выбирает тот класс, чья детекторная область получила больше света. Настоящий результат зависит от геометрии и реакции устройства, даже когда симуляция начинается с идеализированного распространения.
Проблема калибровки проявляется ясно. Начальные фазовые маски классифицировали 98% тестовых цифр в идеальной модели и лишь 35% на реальном аппарате. Небольшое физическое отличие меняет путь света, положение сфокусированных пятен и сигнал детекторов. Обычный подход измеряет устройство, настраивает его цифровую модель и обучает сеть через неё. Калибровочная база этого опыта использовала около 67 000 кадров камеры. После калибровки и обучения она получила 96,3% на оборудовании.
Другая ветвь использует безградиентные пробы на приборе. В статье сравнили proximal policy optimization и policy gradient. Здесь эти методы увеличили точность с 35% примерно до 52%. Это полезная база, но не весь набор методов без модели и не все оптические сети. Результат зависит от конструкции, бюджета измерений, настроек поиска и аппаратуры. Авторы описывают оптимизаторы и применяют одинаковые начальные маски и бюджет стенда.
Практический вопрос заключается в том, помогает ли система понять разрыв, а не только увеличить балл. Новая маска может улучшить один класс, не объясняя причины. Анализ пространственных измерений даёт агенту более полезное понимание устройства. Тогда оценка спрашивает не только о качестве результата, но и о том, какая информация привела к конструкции и сможет ли другой запуск проверить ход рассуждения. Статья даёт агенту больше, чем скалярную награду. Эксперимент и стенд агента
Проблема существует за пределами оптики, потому что реальные системы содержат особенности, отсутствующие в идеальных моделях. Но у оптического распространения собственная математика, а агент использует усвоенные знания об оптике и программировании. Исследование не удостоверяет перенос подхода на любые приборы и процессы. Оно показывает, каким образом тщательно сделанный интерфейс позволяет модели изучить один реальный аппарат по измерениям в контролируемом опыте.
Стенд превращает измерение в вопрос#
Агент не управлял оптикой напрямую. Он находился в изолированном пространстве и взаимодействовал через программу исследователей. Она позволяла выставить маску на модуляторе, получить кадр, оценить кандидат и проверить его на тренировочных цифрах. Каждый запрос требовал гипотезу и ожидаемый результат. Это превращает измерение в проверку текущего понимания прибора, а не очередную слепую попытку поднять балл.
Каждый кадр расходовал общий бюджет измерений. Агент записывал наблюдения в файл, который мог передаваться в следующую сессию. Выполнение шло только на CPU. Задача запрещала численные модели распространения света, доступ к GPU, сети и внешним файлам. Эти ограничения важны. Они исключают некоторые пути решения из симуляции или внешнего источника и делают измерения камеры главным источником обучения. Стенд определяет, какие доказательства получает агент.
Исследователи пишут, что агент заметил изменение положения фокусных пятен между классами, а не только их яркости. Он разделил маску на блоки, зондировал реакции и спроектировал «маршрутизатор пятен», отправляющий классы цифр к своим областям. Первая версия, по статье, обошла окончательную точность безградиентной базы примерно после одной седьмой бюджета измерений. Это конкретный показательный проектный путь, не доказательство обнаружения того же принципа в каждом запуске.
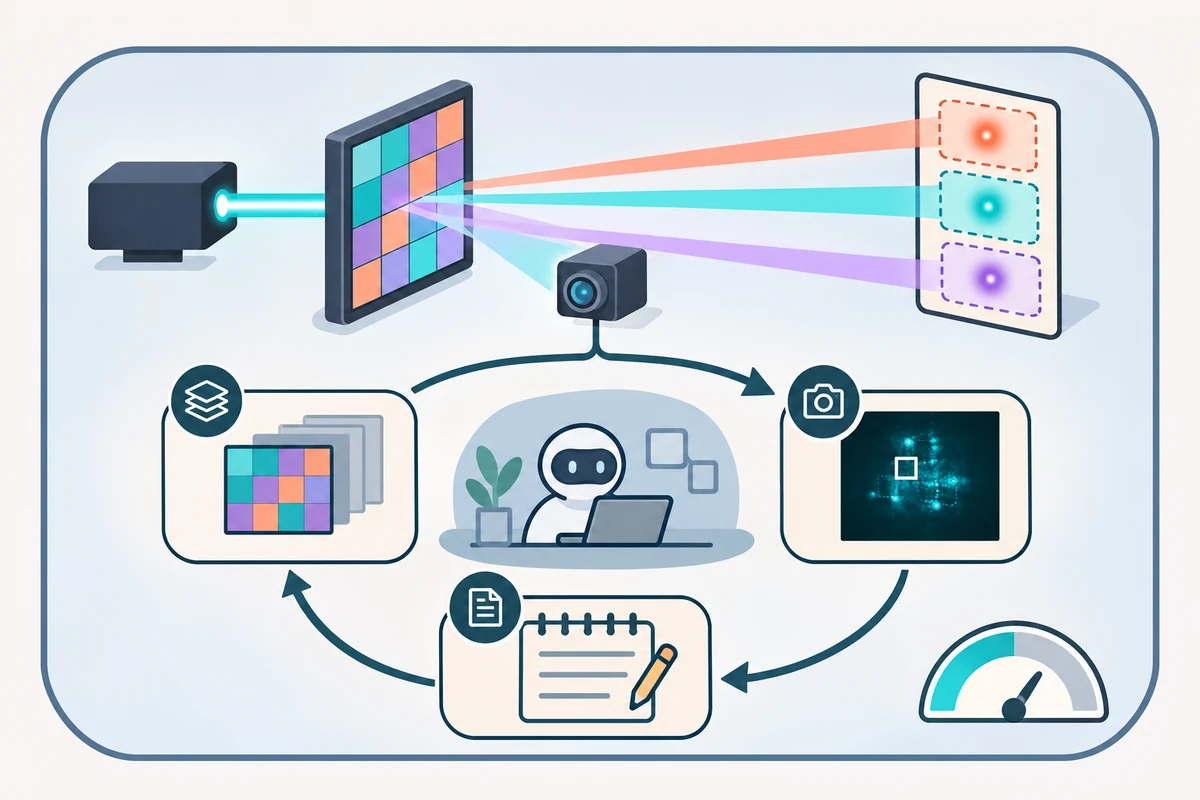
В абляциях обнаружилась роль доступа к информации. Удаление снимков, зондов или требования выдвигать гипотезу влияло на работу. Дополнительные правила принятия решений или распределения бюджета не улучшили точность. Авторы считают это признаком большей пользы наблюдений, чем инструкций. Это практический урок для экспериментальных интерфейсов. Он относится к данному стенду и его проверкам, а не к общему закону о бесполезности подсказок.
В эксперименте можно передать в новую сессию код и заметки предыдущей. Они не содержали фазовых масок или тестовых данных, а сохраняли наблюдения об устройстве. Лучшие результаты классификации пришли от сессий с прежними заметками. Это открывает возможность изучить прибор и передать сведения дальше, сокращая повторную характеристику. Применимость записей к другим аппаратам, монтажам и лабораториям остаётся отдельным вопросом. Здесь дан ранний результат в определённых условиях.
Бюджет показывает компромисс времени и количества проб. Классификатор имел 51 200 измерений камеры, энкодер — 25 600. Одно измерение занимало около 0,107 секунды, поэтому сбор полного бюджета классификатора занимает примерно полтора часа без прочего времени и расходов. Стенд ограничивает физические тесты. В развёртывании также нужно учитывать инференс, подготовку, надзор и повторы. Статья сравнивает объём данных и время с калибровкой, но не даёт общего денежного расчёта многих устройств.
Сильный результат классификации имеет узкие границы#
Лучший запуск с заметками прежней сессии получил 96,8% на закрытых 3 147 рукописных цифрах трёх классов. Лучший запуск по одному описанию, без заметок, достиг 91,1%. Безградиентные методы оставались около 52% на физической установке. Обратное распространение через калиброванную модель дало 96,3%. В этой конфигурации лучший агентский запуск приблизился к базе и немного её превысил.
Авторы также приводят три запуска классификатора с заметками или общими уроками прежних сессий. Точности на тесте составили 89,2%, 91,3% и 96,8%, среднее 92,4%, стандартное отклонение 3,9 процентного пункта. Разброс является полезным контекстом. Он показывает изменение между сессиями, а не устойчивое достижение 96,8%. Работа не даёт гарантии результата на новом устройстве.
Измерительный процесс имеет статистическое ограничение. Тестовый набор конечен, точность имеет неопределённость. При 3 147 примерах авторы оценивают максимальную стандартную ошибку в 0,9 пункта при точности 50% и 0,3 пункта у лучшего запуска. Это неопределённость выборки, а не разброс производственных партий, условий среды, устройств и версий модели. Более широкая заявка на надёжность потребовала бы измерить эти источники вариации.
Бенчмарк намеренно контролируемый. Агент работает в изолированной безголовой сессии, без человека, который вводит команды. У него нет GPU, сети и посторонних файлов. Тестовые цифры запечатаны. Эти меры сокращают часть утечек и упрощают сравнение, но не являются независимой репликацией. Работа — препринт исследователей, создавших стенд и эксперимент. Выводы следует читать на этом уровне доказательств.
Результат остаётся важным. Калибровка отдельной цифровой модели для каждого устройства может потребовать специалиста и больших данных. Агент, изучающий прибор и настраивающий его с помощью измерений, может уменьшить часть работы. Нынешнее доказательство уже: одна лабораторная установка, созданный интерфейс, меньше измерений, чем в опорной калибровке, и сопоставимая точность лучшего запуска. Масштабирование и полная стоимость открыты.
Вторая задача исследует другое использование света#
Статья также испытывает оптический энкодер. Вместо прямой классификации цифр система сжимает изображение Fashion-MNIST в 16 сигналов детекторов. Небольшой цифровой декодер восстанавливает картинку. Маски начинают со случайных значений. Качество измеряется пиковым отношением сигнала к шуму на отложенных изображениях. Задача спрашивает, способны ли тот же агент и стенд обучить компактное оптическое представление, а не только направить цифры к трём детекторам.
С прежними заметками агент достиг 16,1 дБ. PPO получил 15,0 дБ, случайная инициализация — 13,8 дБ. Лучший результат 16,9 дБ получен обратным распространением через калиброванную модель, то есть отставание агента составило 0,8 дБ. Это указывает на возможность второй задачи на той же установке. Данные остаются привязаны к одному оптическому энкодеру и ограниченному набору изображений.
Оптический энкодер может помочь потому, что обработанная светом информация затем часто передаётся, хранится или обрабатывается электроникой. Сжатие до меньшего числа выходов детектора может уменьшить стоимость этого этапа. Коммерческое преимущество не доказано. В статье измерена реконструкция и сравнено обучение. Нет анализа расходов развёртывания, пропускной способности производства или оценки экономики полной системы.
Сравнение языковых моделей даёт ещё один сигнал. Статья сообщает, что более способная в исследуемой группе Claude Fable 5.2 обошла Opus 5.5 и Sonnet 5 на энкодере с тем же описанием задачи. Авторы предполагают улучшение при более сильных моделях. Это правдоподобная трактовка опыта, не гарантия для других систем. Модели быстро меняются, а опыт включает малую группу и один стенд.
Вторая задача показывает, почему выводы должны соответствовать измерению. Точность классификации и PSNR реконструкции описывают разные результаты. Фраза «агент лучше обучает оптические сети» без метрик вводила бы в заблуждение. Точный отчёт разделяет задачи, называет базовые методы и условия. Так специалисты по оптике могут понять, относится ли сравнение к их приборам и целям.
Стенд может оказаться наиболее переносимым вкладом#
Под названием «optics as code» авторы описывают написание и проверку программ управления оптическими компонентами. Элементы представлены интерпретируемыми линзами, призмами и аберрациями. Вместо независимого изменения сотен тысяч пикселей агент формулирует гипотезу об эффекте компонента и проверяет её на устройстве. По статье, некоторые связи прибора характеризовали существенно меньшим числом измерений, чем потребовала полная калибровка модели.
Характеризация является промежуточным достижением, а не только способом поднять балл. Агент наблюдал, где появляются оптические плоскости, как маски перенаправляют свет и насколько выравнивание отличается от номинального. Он записал наблюдения и использовал их в конструкции. Оптик может проверить измеренные отношения и соответствие известной физике. Часть ценности — в видимой цепи наблюдений, а не в загадочном изменении весов.
Стенд поэтому интересен создателям инструментов. Каждое зондирование относится к физическому прибору. Интерфейс возвращает снимки и требует гипотезу. Общий бюджет показывает цену проб. Файл заметок служит памятью между сессиями. Эти решения определяют возможности обучения. Другой интерфейс, возвращающий численную награду, создавал бы другую ситуацию. Абляции подтверждают важность наблюдений для своих опытов.
Лабораториям полезно сделать аппаратуру понятной через программный интерфейс. Агенту нужны безопасные ограниченные действия и содержательный отклик. Исследователю нужно видеть запрос и его причину. Стенд вводит бюджеты, изолирует файлы и сохраняет журналы. Это принципы, подсказанные опытом. Статья не даёт готовой платформы для всех приборов, а показывает специально устроенный интерфейс для оптического монтажа.
Безопасность важна даже в контролируемой лаборатории. Агент использует ограничённое пространство и заранее определённые средства измерения. Он не управляет прибором без контроля и не имеет общей сети и файлового доступа. Это облегчает проверку. Для других устройств надо определить действия, подходящие для автоматизации, безопасные диапазоны и измерения, требующие согласования. Это работа по развёртыванию, а не свойство языковой модели.
Перенос заметок выглядит многообещающим, но пока предварительным. Сессия с предыдущими записями получила лучший результат классификации. Возможно, агенту не всегда нужно заново узнавать свойства одного прибора. Лаборатории следует проверить актуальность записей после замены, обслуживания или выравнивания. Версии заметок могут соответствовать состоянию оборудования. Иначе верное в прошлом наблюдение приведёт следующую сессию к неверной настройке. Память полезна, если её можно проверить.
Одну установку нужно отличать от многих устройств#
Оптические сети привлекательны параллельной передачей и малыми потерями света. Эти свойства мотивируют исследования быстрых экономных вычислений. Но каждое устройство обладает собственными отклонениями. Схема, работающая в лаборатории, может требовать новой настройки при перестановке, замене или производственном разбросе деталей. Мотивация обучения на месте связана с этим различием аппаратов.
Опыт использует фазовый пространственный модулятор, зеркало, лазер и камеру. Две маски содержат сотни тысяч пикселей. Это содержательное физическое устройство, одновременно ограничивающее обобщение. Результат не доказывает неизменный перенос метода на другой модулятор, длину волны, архитектуру, расположение детекторов или нелинейный материал. Авторы обсуждают более широкие возможности, а измеренные данные относятся к этому монтажу.
Запечатанный тест и общий стенд поддерживают справедливость сравнения. У агента и безградиентных баз одинаковые начальные маски, бюджет и структура валидации. Каждый метод оценивается на отложенных цифрах. Это аккуратное проектирование опыта. Уверенность повысят повторы независимыми группами, на других приборах и задачах. Они покажут, переживает ли метод одну благоприятную установку.
Издержки тоже нужно измерять шире. Опорная калибровка получила около 67 000 кадров, агент использовал меньше измерений. Это сравнение эффективности данных. Эксплуатационное сравнение должно также учитывать модельный инференс, подготовку и доступ к устройству, обслуживание, повторы и человеческий контроль. Статья не даёт универсального экономического результата. Внедрение множества устройств потребует полной цены их настройки и работы.
Появляется вопрос о смене языковой модели. Статья предполагает улучшение с более сильными моделями по результатам энкодера. Хостинговый ассистент может изменить поведение после обновления. Для воспроизводимого процесса стоит сохранять модель, режим рассуждения, оборудование и бюджет. Это предложение для оценки, не ошибка, сообщённая авторами. Оно объяснит, почему две сессии пришли к разным конструкциям.
Убедительное продолжение сравнило бы раздельную калибровку с агентским зондированием на нескольких устройствах. Можно измерить принятую точность, количество кадров, длительность, неудачи и необходимые экспертные действия. Также проверить безопасный перенос заметок на похожий экземпляр. Это прямое испытание мотивации масштабирования. Пока оно является исследовательской целью, а не результатом эксплуатации.
Наиболее убедителен проверяемый порядок действий#
Главный вклад статьи — последовательность, доступная читателю. Начать с идеальной модели, измерить отклонения прибора, дать агенту средства исследования, сохранить гипотезы и сравнить конструкцию с контролируемыми основами. Это не делает каждый шаг верным, а показывает существенные этапы. Такой стандарт полезен для исследования с ИИ, где красивое итоговое число легко скрывает путь.
Специалист по оптике может спросить, полезны ли зонды, верна ли физическая интерпретация и честно ли сравнение. Системный инженер может изучить границы стенда и бюджет. Создатель научных агентов — роль заметок и гипотез. Детали дают разные способы проверки. Доступность статьи и описание опыта составляют часть ценности.
Репликация всё ещё нужна. Физических запусков немного, прибор один, задачи классификации и кодирования узкие. Три сессии с заметками достигли 89,2%, 91,3% и 96,8%. Разброс стоит показывать рядом с лучшим числом. Можно признать результат и спросить о повторяемости. Неопределённость отложенного теста отличается от вариации устройств и будущих запусков.
Мы оценим результат выше, если независимые лаборатории воспроизведут выигрыш на других аппаратах, сохранят отделение тестов и сообщат общие затраты эксперимента. Мы станем осторожнее, если лёгкая вариация снова требует калибровки или успех сильно зависит от единственного запуска модели. Эти условия наблюдаемы и связывают оценку с будущим опытом, а не с восторгом по поводу ИИ в науке.
Пока «optics as code» выглядит перспективно на одном физическом монтаже. Агент учился по снимкам, формулировал гипотезы и создал классификатор, близкий к калиброванной модели. Это содержательная демонстрация, не универсальный инженер-оптик и не доказательство дешёвого энергоэффективного производства. Различие делает исследование полезнее, показывая и результат, и его границу.
Лабораторный помощник должен показать путь рассуждения#
Идея шире оптических сетей. У многих научных приборов есть регулируемые параметры и отклики для наблюдения. Агент в принципе может предложить настройку, предсказать исход, выполнить ограниченную пробу и изменить модель. Польза зависит от надёжного стенда, диапазонов безопасного действия и понятных специалисту наблюдений. Это направление, предложенное опытом, а не общая возможность, проверенная во всех лабораториях.
Стенд также влияет на стимулы. Оптимизируя точность валидации, система может научиться преследовать одно число. Запечатанный тест защищает итоговую оценку, а авторы исследовали несколько компонентов стенда. Будущая работа может выбрать показатели, точнее отражающие желаемое поведение и устойчивые к игровому обходу. Для текущего оптического опыта доказательства ограничены задачами классификации и кодирования, снимками и бюджетом.
Требование гипотезы в каждом запросе — заметный выбор интерфейса. Оно фиксирует причину измерения и интерпретацию агентом наблюдения. Экспериментальная гипотеза может быть неверна, что полезно при её проверяемости. Запись предсказания и результата показывает, пересмотрел ли агент понимание или просто изменил параметры. Это делает автоматизацию прозрачнее и помогает исследователю изучить метод.
Межсессионная память влечёт научную ответственность. Заметки должны содержать показания, условия и предварительные выводы. Следующий агент может проверить старое наблюдение зондом. Человек может определить, не обесценило ли его новое выравнивание. Поэтому память физического исследования следует связывать с состоянием прибора и метаданными сессии, а не сохранять исключительно свободный текст. Это последствия для будущих систем, не готовые функции статьи.
Первый вопрос внедрения — не замена специалиста, а способность помочь ему получить информативные измерения и проверить конкретную идею. Статья предлагает путь такого сотрудничества. Учёный отвечает за интерпретацию доказательства и значимость результата. Сдержанная постановка убедительнее широкой заявки на автоматическое открытие, поскольку описывает наблюдаемую работу.
Результат стоит обсуждать вместе с лабораторным стендом#
Авторы работают в Stanford и EPFL. Их работа на arXiv является препринтом, а сайт проекта доступно описывает бенчмарк. Бумага сообщает о реальной оптической установке и контролируемых сравнениях. Обсуждение запуска не заменяет независимой репликации. Данные следует считать результатом команды-участника, который ждёт обычной проверки и воспроизведения нового метода.
Результат классификации интересен преодолением разницы между идеальной и несовершенной схемой. Стенд передаёт агенту наблюдения вместо одного балла. Энкодер подсказывает другое применение. Этих причин достаточно для интереса. Они не оправдывают обещание дешёвого обучения всякого оптического процессора без любой калибровки.
Сильный путь развития опубликовал бы дополнительные настройки, журналы и независимые запуски на нескольких экземплярах. Исследователи могли бы выяснить, учит ли метод устойчивые свойства или адаптируется к одному сеансу. Можно сравнить время специалиста на калибровку модели со временем надзора за агентом. Это покажет, где ресурсы экономятся, а где только перемещаются.
Прозрачность представлена технической возможностью. Заметки, гипотезы, кадры и видимый бюджет позволяют изучить путь агента. Зрелый научный инструмент может сохранить проверяемость, добавив управление экспериментом, версии калибровки и воспроизводимые тесты. Детали зависят от прибора. Принцип в том, что автоматизация показывает причину действия и наблюдение, определившее следующий шаг.
Наша оценка изменится при повторении работы на разных оптических устройствах, сохранении преимущества между сессиями и учёте полной стоимости. Она станет слабее, если малое смещение убирает выигрыш или заметки не переносятся. Это критерии для исследователя и ответственного за внедрение перед расширением вывода за пределы нынешнего стенда.
Пока исследование даёт полезный результат: агент программирования, ограниченный экспериментальным интерфейсом, может описать и обучить реальную оптическую сеть по измерениям. Научная ценность не только в 96,8%. Статья показывает, что агент измерял, как интерпретировал аппарат и какие ограничения повлияли на результат. Видимость этого пути превращает перспективную демонстрацию в метод, доступный оценке.