Un robot qui franchit un obstacle dans un simulateur n’a résolu un problème d’ingénierie que si la machine réelle fait de même. Une nouvelle étude du MIT place cet écart au centre de RoboBuilder, un benchmark où des agents de programmation conçoivent robots et programmes moteurs à partir de pièces disponibles. Chaque conception qui passe en simulation est assemblée à la main et testée sur un parcours physique. En cas d’échec, l’agent reçoit une vidéo et peut revoir son dessin. Article RoboBuilder
À notre avis, la boucle importe davantage que la nouveauté consistant à demander à un agent de dessiner un robot. Les premiers agents logiciels recevaient vite des résultats exacts. Les machines physiques passent par fabrication, matériaux, assemblage, alimentation et mesures imparfaites. RoboBuilder relie la conception à cette réalité plus lente. Les preuves sont prometteuses pour un benchmark, mais ne prouvent pas qu’une IA générale sait concevoir des robots fiables dans tout environnement. L’étude porte sur un inventaire limité, dix obstacles et un laboratoire précis.
Une simulation est une prévision du monde physique#
La recherche part d’une difficulté courante d’ingénierie. Le robot doit être assemblé à partir de pièces réelles, ses joints doivent tenir, les engrenages s’emboîter et ses moteurs fournir la force nécessaire. Un simulateur approche ces conditions, mais ses simplifications comptent. Dans RoboBuilder, quinze conceptions initialement réussies en simulation n’ont franchi aucun parcours réel. Les pneus patinaient, des liaisons se séparaient, des engrenages sortaient de leur maille et des charges se déplaçaient. Ce n’était pas une petite erreur sur les performances : c’était la différence entre passer et échouer.
Les pièces physiques ne se comportent pas parfaitement comme leur fiche produit. Le benchmark utilisait initialement des données publiques sur les pièces et des estimations. Les auteurs rapportent qu’une liaison à axes de friction tenait environ 4,5 N·mm, tandis que le simulateur en supposait 24,5. Cet écart peut changer une décision de conception. Un train de roues qui transmet le couple en simulation peut patiner sous charge en réalité. Un simulateur non vérifié contre des essais physiques risque de récompenser l’exploitation du modèle plutôt que la résolution de l’obstacle.
Le benchmark utilise des pièces standard compatibles avec des briques, moteurs, composants électroniques et un nombre limité de pièces imprimées en 3D. L’inventaire compte 132 types et environ 3 000 pièces disponibles. Un robot qui passe utilise une médiane de 114 pièces. Chaque agent écrit également un programme moteur en boucle ouverte, sans intervention pendant l’essai. Cela donne un espace de conception tangible et borne l’expérience de sorte que des prototypes physiques répétés restent faisables. Présentation et benchmark
Les tâches comportent dix obstacles à trois niveaux. Un robot doit atteindre l’objectif dans le temps imparti et rester debout pendant cinq secondes. Certaines tâches autorisent une pièce imprimée, avec limites de quantité et de dimensions. Les obstacles demandent des mécanismes différents. Une traversée favorise portée et stabilité ; une corde peut avantager un châssis léger ; un mur demande du dégagement ou un mécanisme de soulèvement. Les mêmes pièces permettent de nombreuses stratégies.
Ces contraintes font davantage de RoboBuilder un benchmark d’ingénierie contrôlé qu’une tentative de créer un robot commercialement utile. C’est une force pour étudier la boucle de conception, mais aussi une limite de généralisation. Les résultats d’un parcours de briques ne prédisent pas directement le transport d’objets inconnus parmi des personnes ni plusieurs mois de fonctionnement sans chercheurs. Rendre la frontière du benchmark explicite aide à apprécier l’expérience sans lui demander de répondre à une question plus vaste que ses mesures.
Les agents recherchent dans un espace contraint#
RoboBuilder demande aux agents de programmation de concevoir matériel et logiciel ensemble. Ils choisissent pièces et connexions, créent une géométrie personnalisée facultative et définissent des commandes moteur temporisées. Il ne s’agit pas seulement de générer un rendu CAO. L’assemblage doit respecter inventaire et règles, tandis que le programme doit faire franchir l’obstacle. Les deux aspects interagissent. Le même châssis peut se comporter autrement avec une autre séquence moteur, et une meilleure séquence ne sauvera pas forcément un joint faible ou une structure instable.
L’espace de conception reste immense. Les auteurs estiment qu’avec l’inventaire, même les assemblages de 25 pièces produisent environ 10 puissance 68 combinaisons. Les robots qui passent comptent une médiane de 114 pièces et les programmes moteur varient selon les temporisations et les forces. Cela explique l’impossibilité d’énumérer manuellement toutes les machines. Cela ne signifie pas que les agents ont exploré tout l’espace. L’expérience s’appuie sur un outil de benchmark attribuant à chaque exécution un budget limité de simulations et une série de tâches définies.
Quatre agents de programmation ont été testés, avec 16 427 simulations de 12 774 robots différents et 135 machines construites à la main. Ils ont résolu presque tous les obstacles faciles et conçu des mécanismes absents des bases de recherche. Leur réussite baisse aux niveaux difficiles. Dans l’épreuve « tout-en-un », une seule machine devait franchir les dix obstacles de niveau un ; les conceptions en ont passé au maximum six. Une conception spécialisée pour un obstacle pouvait utiliser une structure différente. Un robot universel doit faire des compromis.
Ce contraste offre un résultat pertinent pour l’ingénierie pratique. Les produits réels doivent souvent répondre à plusieurs exigences simultanées, pas gagner un score isolé. Passer un obstacle de benchmark ne suffit pas à créer un système utile. L’épreuve tout-en-un pose une question plus difficile, et les résultats chutent. L’étude présente donc à la fois des capacités d’agent et les limites du transfert de ces capacités vers un produit complet. Résultats du benchmark
L’article indique aussi qu’explorer davantage ne prédit pas nécessairement une meilleure conception. L’agent le plus fort réussissait souvent avec son premier concept. Ce résultat concerne la distribution des tâches et le budget de cette expérience. Il peut refléter des connaissances d’ingénierie apprises, des motifs reconnaissables du benchmark ou les deux. L’article examine diversité et recherche, mais une observation du benchmark ne devrait pas devenir une loi générale selon laquelle l’exploration ne sert jamais la conception robotique.
Le retour vidéo change ce que l’agent peut apprendre#
Le choix central de RoboBuilder consiste à renvoyer à l’agent une vidéo d’échec physique. Il inspecte le comportement du prototype, modifie son modèle du simulateur et revoit la machine. Le flux relie trois activités : simuler, construire et tester les conceptions acceptées, puis apprendre des échecs réels. C’est une boucle d’ingénierie plus significative qu’un simulateur traité comme verdict définitif.
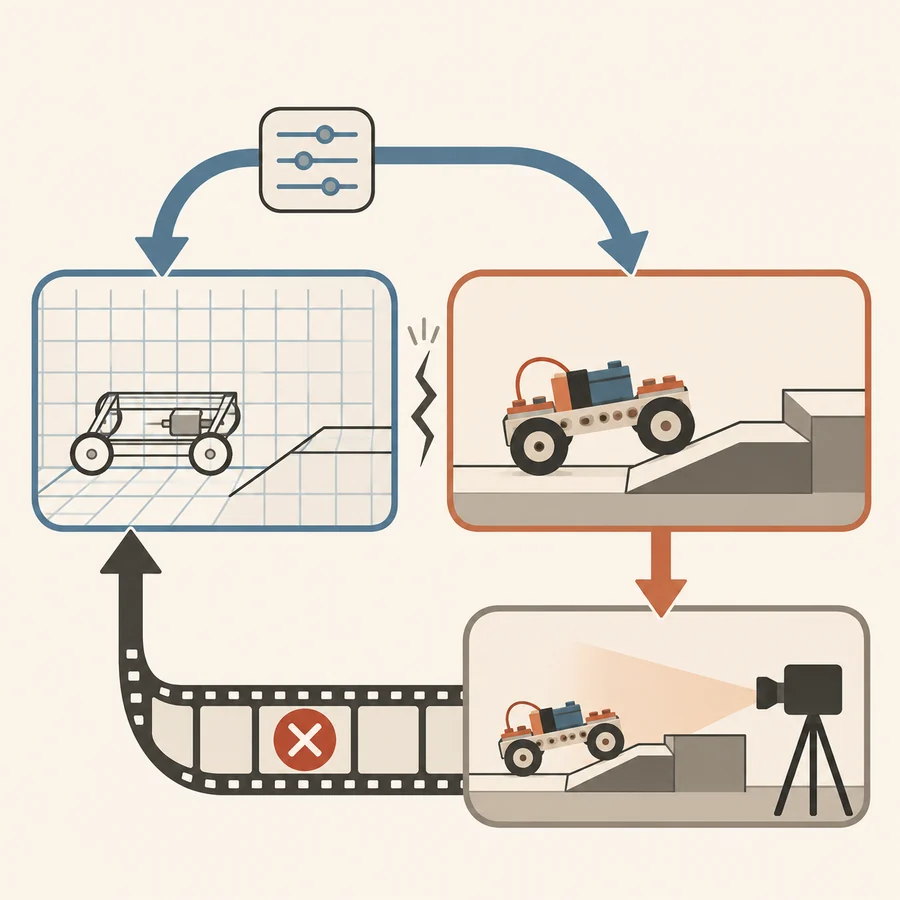
La boucle commence par un écart. Aucun des quinze premiers robots passant le simulateur fondé sur les données publiques de pièces n’a réussi le parcours réel. Chercheurs et agents ont ensuite demandé des mesures physiques, comme friction et résistance des joints, et ajusté le simulateur. Après apprentissage à partir des essais, environ deux tiers des réussites simulées se sont reproduites en réel dans la comparaison de niveaux plus large. Ce chiffre a une population définie et ne doit pas être mélangé aux résultats ultérieurs des niveaux faciles.
L’article rapporte un chiffre supérieur pour les tâches les plus faciles. Aux niveaux un et deux, 73 % des conceptions réussies en simulation passaient aussi en réalité après apprentissage du simulateur. Après présentation d’une vidéo d’échec et une nouvelle conception, les agents ont éliminé 72 % des échecs physiques de niveaux un et deux en une boucle. Le site du projet résume le taux résultant à 93 %. Ces valeurs portent sur des étapes et sous-ensembles différents. Les quinze premiers, la comparaison globale et le résultat facile après boucle n’ont pas le même dénominateur.
Une défaillance précise apprend davantage qu’un score. Des roues patinant contre une bosse peuvent signaler une mauvaise friction simulée, une mauvaise position des roues ou une commande moteur au mauvais moment. La vidéo fournit des observations pour distinguer les explications. Un cas décrit des roues à rayons passant la simulation mais tournant dans le vide contre une crête réelle. L’agent a réduit le coefficient de friction du plastique contre les tiges de bosse dans son modèle, puis conçu un mécanisme à roues entraînées par vis sans fin qui a franchi l’obstacle. C’est un cas du benchmark, pas une garantie que chaque vidéo explique facilement un échec.
La boucle change le rôle du simulateur. Il reste utile pour essayer beaucoup de conceptions à faible coût, mais ses prévisions deviennent des hypothèses confrontées au matériel. Cette relation entre modèle et machine est raisonnable, avec un coût élevé. Les auteurs estiment à 240 heures le travail de construction et d’essai de 135 robots ; ils ont produit 461 vidéos réelles appariées aux simulations. Le retour physique vaut davantage qu’un score simulé, mais coûte plus cher. Le benchmark rend cette contrainte visible et éclaire les ressources requises pour étendre la méthode.
La réussite réelle a des dénominateurs précis#
Le chiffre le plus mémorable est aussi le plus facile à utiliser à tort. Le résumé indique que 66 % des réussites en simulation se vérifient en réalité, tous niveaux confondus. La page projet parle de deux sur trois et de la correction ultérieure de la plupart des échecs aux niveaux faciles. L’article présente aussi 57 sur 86 réussites simulées aux niveaux un et deux après apprentissage, soit environ 66 %, puis 73 % pour un sous-ensemble facile et 93 % après la boucle. Il faut associer chaque résultat à sa population et son étape.
Le résultat initial de 0 sur 15 est également conditionnel. Il concerne les premiers modèles passés avec un simulateur fondé sur les données publiques, avant calibration par observation physique. Ce n’est pas un taux d’échec général des méthodes de robotique simulée. Il révèle l’inadéquation initiale de ce simulateur aux pièces et parcours mesurés. La transition du résultat initial au modèle révisé rend visible la valeur de l’étalonnage.
Les 93 % après boucle ne signifient pas que 93 % des robots ou tâches quelconques réussissent. Ils concernent les échecs de niveaux un et deux de ce benchmark, après une séquence de reprise bornée. Les agents recevaient les vidéos, suivaient un protocole limitant certaines modifications à deux paramètres et devaient repasser le simulateur révisé. L’équipe construisait les robots à la main. Ces contrôles rendent le résultat interprétable et limitent la généralisation.
Les auteurs signalent d’autres limites dans les compléments. Le simulateur est ajusté à partir d’une caméra fixe et d’essais sur banc, donc certains paramètres physiques ne sont pas identifiables. Chaque correction de boucle vise un échec précis. Les conceptions optimisées pour la légèreté et la vitesse n’ont pas été construites. Ces limites délimitent les résultats validés physiquement et ceux qui restent dans la simulation. Tout jugement doit respecter l’étendue réelle des essais.
La variance d’une exécution à l’autre compte aussi. Un passage complet à travers toutes les tâches demanderait près de 4 000 simulations par agent, et les auteurs ne l’ont pas répété. Ils ont cependant testé quatre robots tout-en-un sous des perturbations d’emplacement initial, de retard de commande et de tension de batterie. Certains obstacles sont restés instables. Cela apporte un indice de robustesse et rappelle qu’un franchissement réussi une fois ne caractérise pas toute la fiabilité.
La boucle de laboratoire est une preuve coûteuse#
La robotique physique a une structure de coûts différente des tests logiciels. Un agent logiciel reçoit parfois un verdict exact en quelques secondes. Le robot demande pièces, assemblage, caméras, parcours et personnes pour observer. Les quelque 240 heures de construction et d’essai rapportées rendent cette ressource visible. Les agents génèrent les simulations à grande échelle, mais les retours réels restent le goulot qui relie le modèle au comportement physique.
Cela compte pour l’adoption. Un laboratoire peut étudier la conception par agents et l’adaptation du simulateur avec ce benchmark contrôlé. Une entreprise construisant un produit doit aussi répondre à la durabilité, aux variations de pièces, à la sécurité et aux usages hors parcours préparé. L’article ne prétend pas résoudre ces questions. Il fournit une structure expérimentale pour l’une d’elles, avec un inventaire défini, et rend disponibles des dessins, simulations et vidéos appariées.
La distinction entre laboratoire et produit n’est pas une critique de la recherche. C’est ainsi que s’accumulent les preuves. Un benchmark peut montrer qu’un agent propose des dessins physiques, apprend d’un écart précis du simulateur et améliore ses résultats sur des parcours définis. Il ne suffit pas à établir un déploiement sûr dans un environnement ouvert. Il faudrait de nouvelles tâches, d’autres matériels, des essais répétés de fiabilité et des critères de sécurité explicites.
La fabrication reste aussi à la charge de quelqu’un. Dans l’étude, les robots étaient construits à la main. L’agent peut concevoir des pièces et programmes, mais le processus dépend encore de leur fabrication et assemblage. Ce n’est pas une usine entièrement autonome. Une formulation exacte est celle d’une co-conception de robots assistée par agent, avec essais physiques construits par les chercheurs.
L’article et le site rendent accessibles simulateur, parcours, modèles, simulations et 461 vidéos réelles appariées. Cela permet à d’autres chercheurs de vérifier définitions et essais choisis, et de repérer les écarts du simulateur. La reproduction demande toujours matériel compatible, pièces, outils et temps. Un jeu de données facilite l’inspection, sans supprimer les ressources nécessaires à des essais physiques.
Pour les développeurs d’outils robotiques, l’idée réutilisable est peut-être d’employer la vidéo d’échec comme interface technique structurée. Elle n’est pas seulement une démonstration : c’est une preuve qui peut modifier le modèle et la conception. Elle doit être appariée à l’essai simulé, à la configuration et à la fiche d’échec. RoboBuilder rend ces relations visibles. Leur transfert à d’autres robots dépendra des capteurs et de la capacité à séparer défaut de conception, de simulation et de fabrication.
Le robot tout-en-un révèle le coût d’exigences concurrentes#
L’épreuve tout-en-un demande à une machine de franchir les dix obstacles de niveau un. Elle en franchit six au maximum. Cela montre simplement pourquoi des réussites isolées ne s’additionnent pas automatiquement en robot général. Une bosse demande de la garde au sol, un pont une voie étroite, une corde peut favoriser un châssis léger, et un mur peut demander une mécanique de soulèvement. Un même matériel doit répondre à des besoins contradictoires.
Ce résultat rejoint une question générale d’ingénierie. Un optimiseur améliore souvent un score choisi, mais les produits doivent arbitrer taille, vitesse, fiabilité, coût et adaptation. L’article propose des tâches de suivi pour alléger ou accélérer des conceptions acceptées, mais ces versions n’ont pas été construites. C’est important. Une baisse de masse simulée ne prouve pas que le robot reste fiable et performant sur le parcours physique.
Le benchmark montre également l’importance de la règle de réussite. Il faut atteindre la cible dans le temps imparti, puis rester droit pendant cinq secondes. Les contraintes d’inventaire et d’assemblage s’ajoutent. Passer la simulation n’est qu’une étape avant l’essai réel. Une machine atteignant la cible une fois ne suffit pas toujours à un usage répétitif. Les critères doivent représenter ce dont l’utilisateur final a besoin.
C’est pourquoi l’étude est plus convaincante comme procédure de recherche que comme promesse produit. Elle décrit comment les agents composent matériel et programme, comment les observations corrigent le simulateur et comment les échecs guident de nouvelles conceptions. L’échec tout-en-un garde les limites visibles. La généralité ne s’obtient pas en ajoutant des obstacles ; il faut voir comment les compromis et perturbations affectent les résultats.
Quels travaux renforceraient la conclusion#
Une étude ultérieure utile répéterait assez le processus complet pour estimer la variance. Les auteurs indiquent le coût d’une exécution complète, avec des milliers de simulations par agent. Ce coût est lui-même une question de recherche. Les équipes pourraient comparer la valeur de simulations supplémentaires et celle d’essais réels supplémentaires. Une allocation mesurée permettrait de savoir où chaque heure ou cycle de fabrication apporte le plus d’information.
Le benchmark pourrait aussi dépasser son inventaire et sa caméra fixes. D’autres matériaux, types de connexion et capteurs testeraient le transfert des connaissances du simulateur. De nouveaux parcours permettraient de distinguer apprentissage de la physique et reconnaissance d’une piste familière. Ce sont des travaux futurs, pas des capacités démontrées. Les limites exposées par les auteurs fournissent une bonne base.
Pour un ingénieur qui envisage un système similaire, l’enseignement immédiat est de traiter le simulateur comme un modèle à entretenir. Enregistrer les hypothèses, demander des mesures physiques aux endroits importants et associer chaque échec réel à la simulation correspondante. Si la machine et le modèle divergent, déterminer si le changement vient du dessin, du simulateur, de l’assemblage ou des conditions d’essai. Ainsi, un diagnostic ne se réduit pas à « l’IA a échoué » ou « le simulateur est faux ».
Le rôle de l’agent doit également rester observable. L’étude a testé quatre agents de programmation, les compare à des méthodes de recherche et sépare niveaux et tâche tout-en-un. Pour évaluer un remplacement de main-d’œuvre, une étude future pourrait comparer à des concepteurs experts sous budget de temps et de matériel équivalent. Ce comparatif n’est pas ici. L’étude démontre une capacité dans un benchmark défini et expose des échecs, ce qui constitue déjà un apport utile.
Notre confiance augmenterait si des laboratoires indépendants reproduisent la boucle, obtiennent des résultats voisins sur de nouveaux parcours et indiquent les heures de calibration et fabrication. Elle diminuerait si les gains disparaissaient avec d’autres pièces ou si les échecs réels demeuraient fréquents sous des essais répétés. Ce sont des critères observables, reliant le jugement aux prochaines preuves plutôt qu’à l’apparence séduisante d’une machine dessinée par agent.
Le dessin décisif est la boucle autour du robot#
RoboBuilder montre des agents qui dessinent plus que des rendus. Ils assemblent des pièces, programment des moteurs, testent en simulation et parfois révisent leur modèle à partir d’un échec physique. À l’échelle d’un benchmark de recherche, les chiffres sont substantiels : 16 427 simulations, 12 774 dessins distincts et 135 machines construites à la main. Ils montrent à la fois une capacité inventive et l’écart réel entre simulation et physique.
L’interprétation utile garde cet écart visible. Un simulateur est précieux parce qu’il permet d’explorer à faible coût. Il devient dangereux quand ses prévisions sont prises pour le monde réel. L’apport de RoboBuilder est le retour des preuves physiques dans le processus, où elles peuvent modifier modèle et machine. Le projet illustre comment rendre une ingénierie assistée par IA plus redevable à la réalité.
Il ne démontre pas un concepteur général prêt pour tout environnement, une fabrication entièrement automatisée ou l’équivalent d’un ingénieur humain. Obstacles, pièces, caméra et commandes en boucle ouverte bornent l’expérience. Le robot tout-en-un ne dépasse pas six obstacles sur dix. Certaines conceptions simulées pour la vitesse et la masse n’ont pas été construites. Ces faits ne diminuent pas le résultat ; ils le délimitent.
Les développeurs devraient donc revoir leur compréhension du mot « agent ». Un système utile ne fournit pas simplement une conception. Il travaille dans un environnement qui expose des observations, conserve des hypothèses et permet aux échecs de corriger le modèle. Le banc d’essai, le simulateur et la fabrication ne sont pas des détails secondaires. Ils déterminent ce que l’agent peut apprendre et ce que signifie réussir.
Pour l’instant, RoboBuilder est un cas fort de liaison entre conception numérique et essais physiques. Sa machine la plus importante est peut-être la boucle qui construit un robot, le regarde échouer et demande ce que cet échec lui apprend. La suite consiste à répéter le cycle avec d’autres dessins, matériaux et tâches en comptant les personnes et le temps requis. C’est le monde réel qui donne au robot le droit de se dire fonctionnel.