Les réseaux neuronaux optiques traitent l’information avec la lumière. Ils peuvent permettre des calculs rapides et sobres en énergie, mais un appareil réel ne correspond presque jamais exactement à sa conception idéale. Un modèle entraîné en simulation peut perdre en précision lorsque des désalignements, des aberrations et le comportement des composants entrent en jeu. Le 18 novembre, des chercheurs de Stanford et de l’EPFL ont publié une étude décrivant un agent qui apprend directement à partir des mesures d’une caméra. Le résultat important est un cycle expérimental structuré, pas une démonstration générale que les modèles de langage comprennent tous les systèmes physiques. Article scientifique
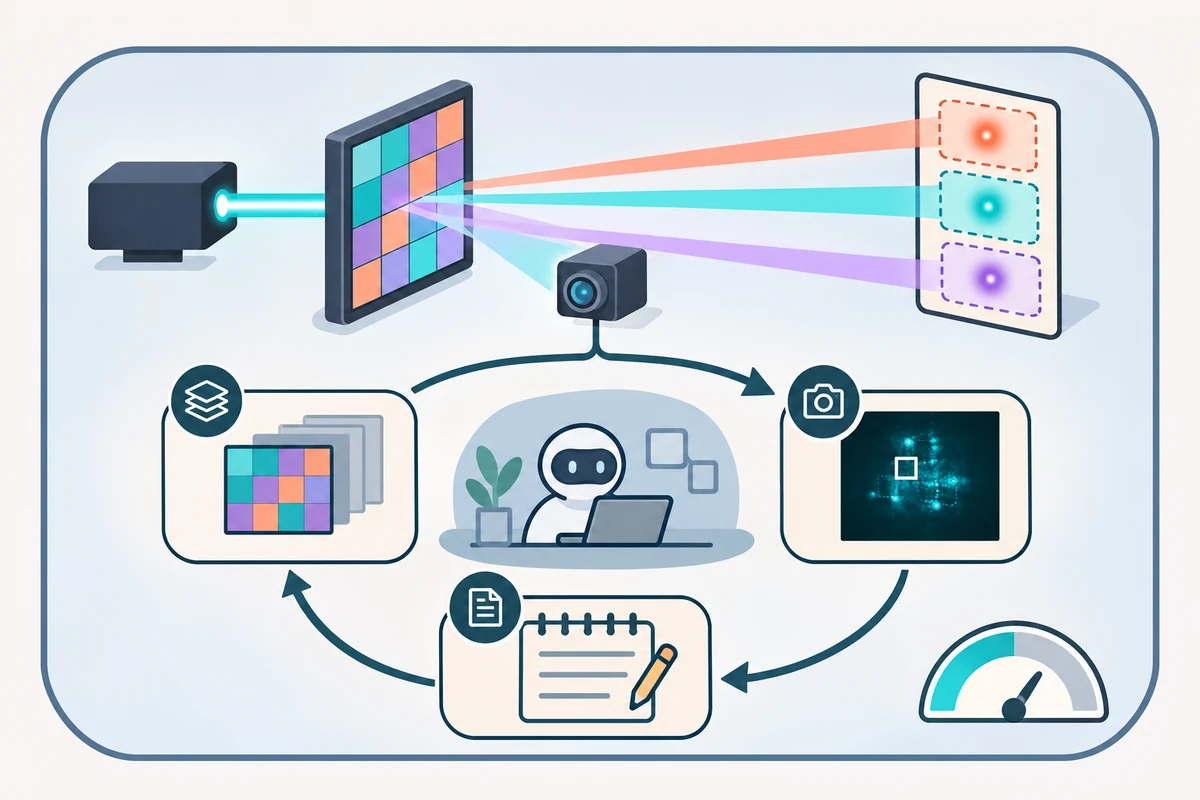
L’article présente « optics as code ». Un agent de programmation propose des programmes et des masques de phase. Un banc expérimental les affiche sur un modulateur spatial de lumière, renvoie des images de caméra et laisse l’agent consigner hypothèses et observations. L’équipe rapporte que son meilleur essai de classification, avec les notes d’une session précédente, a atteint 96,8 % sur le test. Les meilleurs résultats des références sans gradient et de la rétropropagation dans un modèle calibré sont respectivement de 52,5 % et 96,3 %. Le résultat mérite attention pour ce montage. Il vient d’une configuration de laboratoire et de tâches définies. Texte complet et méthodes
Le dispositif s’écarte du modèle idéal#
L’expérience utilise un système où un laser se réfléchit entre plusieurs régions d’un modulateur spatial. Certaines régions encodent l’entrée, tandis que deux autres affichent des masques de phase entraînables. Une caméra mesure l’intensité de sortie. Pour classer les chiffres manuscrits zéro, un et deux, le système choisit la classe dont la zone de détection reçoit le plus de lumière. Le résultat physique dépend de la géométrie réelle et de la réponse du dispositif, même si la simulation commence avec un modèle idéalisé de propagation.
Le problème de calibration est visible. Les masques initiaux classent 98 % des chiffres de test dans la simulation idéale, mais seulement 35 % sur l’appareil réel. De faibles écarts physiques modifient le trajet lumineux, la position des taches focalisées et les signaux des détecteurs. L’approche conventionnelle consiste à mesurer et ajuster un modèle numérique pour chaque appareil, puis à entraîner à travers ce modèle calibré. Dans cette expérience, la référence de calibration a utilisé environ 67 000 images de caméra et atteint 96,3 % sur le matériel après calibration et entraînement.
Une autre approche emploie des essais sans gradient directement sur l’appareil. L’article compare proximal policy optimization et policy gradient. Sur ce montage, ces méthodes sont passées de 35 % à environ 52 %. C’est une référence utile, mais pas l’ensemble des méthodes sans modèle ni de tous les réseaux optiques. Le résultat dépend de la conception, du budget de mesures, des paramètres de recherche et de l’appareil. Les auteurs décrivent les réglages et utilisent les mêmes masques initiaux et le même budget pour le banc.
La question pratique est de savoir si le système aide à comprendre l’écart, au-delà de la seule recherche d’un meilleur score. Un masque candidat peut améliorer une classe sans révéler pourquoi. Si l’agent examine les mesures spatiales, il peut construire une compréhension plus utile du matériel. L’évaluation ne demande alors pas seulement si le résultat est bon, mais aussi quelles informations ont conduit à la conception et si une autre session peut vérifier le raisonnement. L’étude lui donne davantage qu’une récompense scalaire. Expérience et banc de l’agent
Le problème dépasse l’optique, car les systèmes physiques comportent des imperfections absentes de leurs modèles idéaux. Toutefois, la propagation optique a sa structure mathématique, et l’agent s’appuie sur des connaissances préalables de l’optique et de la programmation. Cette étude ne prouve pas que l’approche se transpose à tous les instruments et processus physiques. Elle montre comment une interface soignée peut laisser un modèle apprendre le comportement d’un dispositif à partir de mesures, dans une expérience contrôlée.
Le banc transforme une mesure en question#
L’agent ne manipule pas directement l’optique. Il travaille dans un espace isolé et interagit avec un logiciel construit par les chercheurs. Il peut afficher des masques de phase sur le modulateur, demander une image de caméra, évaluer des masques candidats et les valider sur des chiffres d’entraînement. Chaque demande doit inclure une hypothèse et un résultat attendu. La mesure devient un test de sa compréhension actuelle plutôt qu’un nouveau réglage à l’aveugle pour augmenter un score.
Chaque image utilise le budget commun de mesures. L’agent consigne ses observations dans un fichier de notes transmissible à une session ultérieure. Il fonctionne uniquement sur CPU. La tâche interdit les modèles numériques de propagation de la lumière et bloque l’accès aux GPU, au réseau et aux fichiers extérieurs. Ces contraintes comptent. Elles excluent certains moyens d’obtenir la réponse depuis une simulation ou des ressources externes, et font des mesures de caméra la voie d’apprentissage principale. Le banc définit les preuves accessibles à l’agent.
Les chercheurs rapportent que l’agent remarque le déplacement des taches focalisées selon la classe, au-delà du simple changement de luminosité. Il divise un masque en blocs, sonde leurs réponses et conçoit un « routeur de spots » qui dirige les chiffres vers différentes zones de détection. Selon l’article, la première version dépasse les méthodes sans gradient après environ un septième du budget de mesure. C’est un parcours de conception précis et instructif, sans prouver que chaque essai découvrira le même principe physique.
Les études d’ablation montrent l’importance de l’accès à l’information. Enlever les images de caméra, les sondes ou l’obligation de formuler une hypothèse affecte les capacités de l’agent. L’article indique que des règles supplémentaires de décision ou d’utilisation du budget n’améliorent pas la précision. Les auteurs en déduisent que de meilleures observations l’aident davantage que davantage d’instructions. C’est une leçon utile de conception d’interface, propre à cette expérience et à cette évaluation ; elle ne constitue pas une loi générale sur l’inefficacité des prompts.
Une session ultérieure peut également utiliser le code et les notes d’une session précédente. Ces notes ne contiennent ni masques de phase ni données de test ; elles consignent des observations sur l’appareil. Les meilleures performances de classification viennent de sessions disposant de ces notes. Cela ouvre la possibilité d’étudier un dispositif puis de transmettre ces connaissances, réduisant les caractérisations répétées. La transférabilité entre appareils, montages et laboratoires reste une question distincte. L’article apporte un premier résultat dans un cadre très délimité.
Le budget rend les compromis visibles. La tâche de classification reçoit 51 200 mesures de caméra, et celle d’encodage 25 600. Une image demande environ 0,107 seconde, donc réunir le budget du classificateur prend environ une heure et demie, hors autres temps et coûts. Le banc plafonne les essais physiques. Un déploiement devrait aussi compter inférence, préparation, supervision de chercheurs et répétitions. L’article compare le volume de données et le temps d’entraînement à la calibration, mais ne donne pas de coût monétaire général pour des déploiements à grande échelle.
Un résultat de classification fort mais limité#
Le meilleur essai de l’agent avec les notes d’une session précédente atteint 96,8 % sur 3 147 chiffres de test tenus à part et répartis en trois classes. Sans ces notes, le meilleur essai à partir de la description de tâche atteint 91,1 %. Les méthodes sans gradient restent autour de 52 % sur l’appareil physique. La rétropropagation dans un modèle calibré atteint 96,3 %. Sur ce montage, le meilleur essai agent approche puis dépasse légèrement la référence calibrée.
Les auteurs rapportent aussi trois sessions de classification avec des notes ou leçons antérieures. Leurs précisions de test sont de 89,2 %, 91,3 % et 96,8 %, avec une moyenne de 92,4 % et un écart-type de 3,9 points. Cette dispersion est un contexte utile. Elle révèle des différences entre sessions au lieu d’un 96,8 % stable. L’étude n’établit aucune garantie de performance sur un appareil nouveau.
Les mesures possèdent également une limite statistique. Le jeu de test est fini, et la précision comporte une incertitude. Pour 3 147 exemples, les auteurs estiment une erreur-type maximale de 0,9 point à 50 % de précision, et 0,3 point pour le meilleur essai. Cette incertitude d’échantillonnage ne décrit pas les variations entre appareils, lots de fabrication, conditions ou versions de modèles. Une affirmation plus large de fiabilité nécessiterait aussi de mesurer ces sources.
Le benchmark est volontairement contrôlé. L’agent fonctionne sans personne qui saisit des commandes pendant la session, dans un espace isolé. Il ne peut accéder ni au GPU, ni au réseau ni aux fichiers extérieurs. Les chiffres de test restent scellés. Ces contrôles réduisent certaines formes de fuite et facilitent les comparaisons, sans constituer une réplication indépendante. Il s’agit d’un préprint des chercheurs ayant créé l’expérience et le banc. Les conclusions sont à lire à ce niveau de preuve.
Le résultat n’en reste pas moins intéressant. Calibrer un modèle numérique pour chaque appareil réel peut exiger beaucoup d’expertise et de données. Un agent capable de sonder puis d’ajuster le dispositif peut éventuellement réduire une partie du travail. Les preuves actuelles soutiennent une affirmation plus restreinte : sur ce montage de laboratoire, un agent de code a entraîné un classificateur optique à l’aide d’un banc adapté avec moins de mesures que la référence calibrée, pour une précision similaire au meilleur essai. Le passage à l’échelle et les coûts restent ouverts.
Une seconde tâche examine un autre usage de la lumière#
L’article étudie également un encodeur optique. Au lieu de classer directement des chiffres, le système compresse des images Fashion-MNIST dans 16 signaux de détecteurs. Un petit décodeur numérique reconstruit ensuite les images. Les masques de phase commencent par des valeurs aléatoires. Le test mesure leur qualité par le rapport signal sur bruit de crête sur des images réservées. Il demande si le même agent et le même banc peuvent entraîner une représentation compacte, plutôt que seulement aiguiller quelques classes de chiffres.
Avec des notes antérieures, l’agent atteint 16,1 dB dans l’expérience. PPO obtient 15,0 dB et l’initialisation aléatoire 13,8 dB. Le meilleur résultat est 16,9 dB avec la rétropropagation par modèle calibré. Dans cet essai, l’agent reste à 0,8 dB. Ces chiffres indiquent que l’approche peut répondre à une autre tâche sur le même appareil. Ils restent liés à un unique encodeur et un ensemble restreint d’images de test.
L’encodeur optique peut avoir de l’intérêt parce que l’information calculée optiquement doit ensuite souvent être transmise, stockée ou traitée électroniquement. Réduire une image à moins de sorties de détecteurs pourrait réduire ce coût en aval. L’article ne démontre toutefois aucun bénéfice commercial. Il mesure la qualité de reconstruction et compare l’entraînement, sans analyse économique du déploiement, du débit de production ou d’un système complet.
La comparaison des modèles de langage fournit aussi un signal. Selon l’article, Claude Fable 5.2, le plus capable du groupe testé, dépasse Opus 5.5 et Sonnet 5 avec la même description de tâche pour l’encodeur. Les auteurs en déduisent qu’un modèle plus puissant pourrait améliorer l’approche. C’est une interprétation plausible des résultats, non une garantie générale. Les modèles évoluent vite et l’expérience n’en teste qu’un petit nombre avec un banc.
La seconde tâche rappelle qu’une affirmation doit rester liée à son résultat. La précision de classification et le PSNR d’une reconstruction mesurent deux choses. Résumer cela par « l’agent entraîne mieux des réseaux optiques », sans nommer les métriques, induirait en erreur. Un rapport précis sépare les tâches, nomme les références et expose le contexte. Les chercheurs en optique peuvent alors juger la pertinence pour leur propre appareil et leurs objectifs.
Le banc pourrait être la contribution la plus réutilisable#
Les auteurs appellent leur approche « optics as code » : un agent écrit et teste des programmes de contrôle optique. Le système représente des composants sous des formes interprétables comme lentilles, prismes et aberrations. Au lieu de modifier indépendamment des centaines de milliers de pixels, il peut formuler une hypothèse limitée sur l’effet d’un élément et la tester sur le matériel. Selon l’article, une partie de la caractérisation de l’appareil a demandé beaucoup moins de mesures que la calibration complète du modèle.
Cette caractérisation est un résultat intermédiaire, pas seulement un chemin vers le score final. L’agent examine où les plans optiques apparaissent sur la caméra, comment les masques dévient la lumière et quels écarts existent par rapport à l’alignement prévu. Il note ces observations et les réutilise dans ses dessins. Un scientifique peut inspecter les relations mesurées et juger leur compatibilité avec l’optique connue. Une part de la valeur vient de cette chaîne visible, pas seulement d’un changement de poids opaque.
Le banc intéresse donc les concepteurs d’outils. Chaque sonde a une relation précise à l’appareil ; l’interface retourne des images ; chaque requête doit expliquer une hypothèse ; le budget commun rend la dépense expérimentale visible ; les notes transmettent de la mémoire. Ces choix déterminent ce que l’agent peut apprendre. Une interface ne renvoyant qu’une récompense scalaire créerait une autre situation. Les tests d’ablation de l’article appuient l’importance de ces observations pour leur expérience.
Les laboratoires peuvent en retenir une leçon : rendre l’instrument compréhensible par son interface logicielle. L’agent a besoin d’actions sûres et bornées, et de retours utiles. Les chercheurs doivent voir les requêtes et leur justification. Un banc peut imposer un budget, isoler des fichiers et conserver les journaux. Ce sont des principes inspirés par l’étude. Elle ne fournit pas une plateforme universelle prête à connecter tous les instruments de laboratoire. Elle présente une interface soigneusement construite pour un montage optique précis.
La sécurité compte même dans ce petit environnement expérimental. L’agent reste dans un espace contrôlé et utilise des outils prédéfinis. Il ne possède ni accès réseau, ni accès général aux fichiers, ni commande illimitée de l’instrument. Cela facilite l’inspection et le contrôle du test. D’autres appareils exigeraient de déterminer les actions automatisables, les plages de sûreté et les mesures soumises à une approbation humaine. Ces questions relèvent du déploiement, pas seulement du modèle de langage.
Le transfert des notes entre sessions est prometteur, mais préliminaire. Une session équipée de notes antérieures a produit la meilleure précision de classification. Cela suggère que l’agent peut éviter de caractériser chaque appareil depuis zéro. Un laboratoire devra vérifier la validité des notes après remplacement, maintenance ou réalignement. Elles pourraient être versionnées avec l’état de l’instrument. Sans cette précaution, une observation jadis vraie peut guider la session suivante dans une mauvaise direction. Une mémoire réutilisable n’aide que si sa validité est vérifiable.
Les preuves doivent distinguer un appareil de plusieurs#
Les réseaux optiques attirent en partie par la transmission parallèle et les faibles pertes de propagation. Ces propriétés motivent les recherches en calcul rapide et sobre en énergie. Mais chaque appareil assemblé a ses propres imperfections. Un montage performant dans un laboratoire peut avoir besoin d’une autre calibration après changement de composant, déplacement ou variation de fabrication. La motivation de l’apprentissage in situ est précisément cette spécificité à chaque appareil.
L’expérience utilise un modulateur spatial de phase, un miroir, un laser et une caméra. Deux masques comportent des centaines de milliers de pixels. C’est un système physique substantiel, qui limite aussi la généralisation. L’article ne démontre pas une application identique à tout autre modulateur, architecture, longueur d’onde, agencement de détecteurs ou matériau non linéaire. Les auteurs discutent de possibilités plus vastes, tandis que les preuves mesurées restent liées à ce matériel.
Le jeu scellé et le banc commun améliorent l’équité de comparaison. Références sans gradient et agent utilisaient mêmes masques de départ, budget et validation. Chaque méthode était notée sur des chiffres réservés. C’est une conception expérimentale rigoureuse. Des essais indépendants sur de nouveaux appareils physiques et d’autres tâches renforceraient la confiance. Ils montreraient si la méthode dépasse une seule configuration favorable.
Les coûts demandent aussi une mesure plus large. Le modèle calibré a utilisé environ 67 000 images de caméra, tandis que l’agent a demandé moins de mesures. C’est une comparaison utile de l’efficacité des données. Un déploiement devrait aussi inclure inférence, accès et préparation de l’appareil, entretien, répétitions et revue experte. L’article ne revendique pas de résultat économique général. Pour justifier le passage à de nombreux appareils, il faudrait calculer le coût complet du maintien en état et de la calibration.
Il faut aussi compter l’évolution des modèles de langage. L’article suggère une amélioration avec des modèles plus capables à partir des essais d’encodage. Un assistant hébergé pourrait changer de comportement après mise à jour. Un flux scientifique reproductible devrait noter le modèle et l’effort de raisonnement avec l’équipement et le budget de mesures. C’est une recommandation d’évaluation, pas un défaut signalé par les auteurs. Elle permet de comprendre des différences entre sessions.
Une étude de suivi convaincante comparerait la calibration numérique de chaque appareil à l’apprentissage par sondes sur un ensemble d’appareils. Elle mesurerait précision des résultats acceptés, mesures nécessaires, durée, échecs et intervention experte. Elle vérifierait également si les notes se transfèrent à un matériel proche. Cette évaluation testerait directement la promesse de mise à l’échelle. Pour l’instant, « potentiellement extensible » reste une direction de recherche, pas un résultat de déploiement.
Le résultat le plus convaincant est une séquence vérifiable#
La contribution forte de l’article est une séquence examinable : commencer par un modèle idéal, mesurer ses écarts avec le matériel, fournir des outils de sonde à l’agent, conserver ses hypothèses, puis comparer le résultat à des références contrôlées. Cela ne rend pas chaque étape correcte. Cela rend visibles les étapes importantes. C’est une norme utile pour des expériences assistées par IA, où le chiffre final peut autrement cacher le parcours.
Un spécialiste de l’optique peut demander si les sondes sont informatives, si l’explication physique correspond aux connaissances et si les comparaisons sont équitables. Un ingénieur système examine la frontière du banc et son budget. Un développeur d’agents scientifiques étudie les notes et hypothèses. Les détails permettent ces différents examens. L’accès à l’article et à sa méthode fait lui-même partie de la valeur.
Cela n’élimine pas la nécessité de réplication. L’étude comprend peu d’essais physiques, une configuration et des tâches limitées de classification et d’encodage. Les trois sessions de classification avec notes obtiennent 89,2 %, 91,3 % et 96,8 % ; cette variation mérite d’accompagner le meilleur score. On peut apprécier le résultat tout en demandant sa répétabilité. L’incertitude statistique sur le jeu tenu à part diffère de la variation entre appareils et futures sessions.
Nous serions plus confiants si des laboratoires indépendants reproduisent les gains sur d’autres appareils, préservent la séparation des tests et indiquent l’effort expérimental complet. Nous serions plus prudents si une légère variation matérielle réintroduit un besoin de calibration ou si le résultat dépend d’une seule session de modèle. Ce sont des conditions concrètes qui relient le jugement aux essais futurs, plutôt qu’à un enthousiasme général pour l’IA scientifique.
Pour l’instant, « optics as code » est une méthode prometteuse sur un montage physique. L’agent a appris d’images de caméra, formulé des hypothèses, reçu un retour et construit un classificateur proche de la référence calibrée. C’est une démonstration importante, pas un ingénieur optique universel ni une preuve de matériel de production économe en énergie. Cette distinction rend le travail plus utile, car résultat et périmètre restent tous deux visibles.
Un assistant de laboratoire doit exposer son cheminement#
Cette idée dépasse les réseaux optiques. De nombreux instruments ont des paramètres ajustables et produisent des mesures permettant de comprendre leurs réactions. Un agent pourrait proposer un changement, en prédire l’effet, exécuter une mesure bornée et réviser son modèle. L’utilité dépend d’un banc fiable, de limites sûres et de résultats lisibles par un expert. C’est une direction suggérée, non une capacité générale démontrée dans les laboratoires.
Le banc façonne aussi les incitations. Un système optimisant la précision de validation peut apprendre à poursuivre ce seul indicateur. Le jeu scellé protège une partie de l’évaluation et les auteurs ont étudié les composants du banc. Les travaux futurs pourraient choisir des mesures reflétant le comportement physique voulu et résistantes au détournement. Dans cette étude optique, les preuves restent spécifiques aux tâches de classification et d’encodage, aux images et au budget de mesure.
Exiger une hypothèse par demande est un choix d’interface intéressant. Cela peut documenter la raison d’une mesure et l’interprétation de l’agent. Une hypothèse expérimentale peut être fausse, ce qui reste utile si elle est falsifiable. Consigner prévision et résultat permet de voir si l’agent révise sa compréhension ou ne fait que modifier ses paramètres. Cette méthode aide à auditer l’automatisation et donne au chercheur une meilleure vue du processus.
La mémoire entre sessions comporte aussi une responsabilité scientifique. Les notes devraient conserver observations, conditions et conclusions provisoires. Une session future peut vérifier une observation précédente avec des sondes. Une équipe humaine peut déterminer si un réalignement l’a invalidée. Cela suggère de relier la mémoire à l’état de l’appareil et aux métadonnées de session, au lieu de n’en garder qu’un texte libre. Ce sont des implications d’implémentation future, pas des fonctions que l’article prétend résoudre.
La première question d’adoption n’est pas de remplacer un expert. C’est de savoir si l’agent peut l’aider à obtenir des mesures informatives et à tester une idée délimitée. L’article montre une voie de collaboration. Le scientifique reste responsable de l’interprétation et de la valeur du résultat. Cette formulation modeste est plus crédible qu’une promesse de découverte autonome, puisqu’elle rattache le système à un travail observable.
Le résultat mérite attention sans perdre le banc de vue#
Les auteurs travaillent à Stanford et à l’EPFL. Leur article arXiv est un préprint, et le site du projet fournit une présentation lisible du benchmark. Le travail rapporte une expérience soigneusement contrôlée sur un véritable montage optique. Les discussions publiques au lancement ne constituent pas une réplication indépendante. Il faut le lire comme un résultat de première main de l’équipe, à soumettre aux examens et répétitions ordinaires d’une nouvelle méthode.
La classification est frappante parce qu’elle franchit un écart entre conception idéale et appareil imparfait. Le banc donne à l’agent des observations pertinentes, pas un simple score. L’encodage suggère un second emploi. Ces éléments justifient l’intérêt. Ils ne justifient pas d’en faire la promesse qu’un processeur optique quelconque sera entraîné à bas coût sans calibration.
Un développement solide publierait d’autres configurations, journaux de mesure et essais indépendants sur plusieurs exemplaires. Les chercheurs pourraient vérifier si la méthode apprend des propriétés physiques stables ou s’adapte à une seule session. Ils pourraient comparer le temps expert nécessaire à la calibration et la supervision de l’agent. Ces comparaisons montreraient où le travail est économisé et où il est déplacé.
L’article présente la transparence comme fonction technique. Notes, hypothèses, images et budget visibles permettent d’examiner le parcours. Un outil de recherche mûr pourrait conserver cette auditabilité avec gestion d’expérience, calibration versionnée et jeux de test reproductibles. Les détails varient selon l’instrument. Le principe est que l’automatisation physique explique pourquoi elle agit et quelles preuves déterminent l’étape suivante.
Notre évaluation changerait si l’approche se répète sur des dispositifs optiques distincts, conserve ses gains entre sessions et chiffre le coût de déploiement complet. Elle serait affaiblie si un faible désalignement élimine l’avantage ou si les notes se transfèrent mal. Ce sont des critères qu’un scientifique ou un responsable technique peut examiner avant d’étendre la portée au-delà du banc décrit.
Pour l’instant, l’étude livre un résultat de recherche utile : un agent de programmation contraint par un banc expérimental peut caractériser et entraîner un véritable réseau optique à partir de mesures. La valeur scientifique ne tient pas seulement aux 96,8 %. L’article montre ce que l’agent a mesuré, comment il a compris le matériel et quels contrôles ont façonné le résultat. Rendre cette démarche visible transforme une démonstration prometteuse en méthode évaluable.